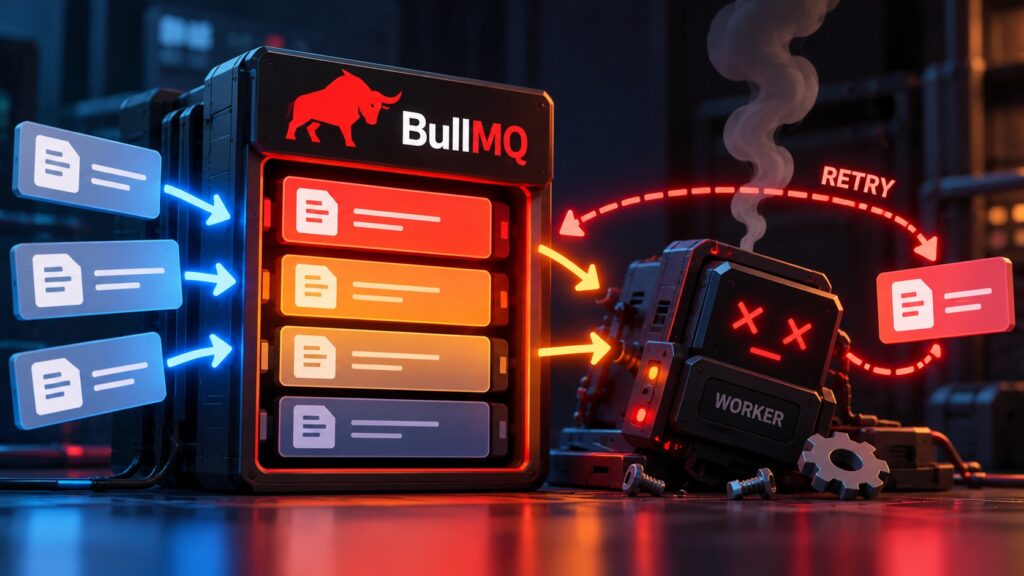
Todo worker do BullMQ que chama uma API externa, como um gateway de pagamento, um ERP ou um serviço de e-mail, funciona bem até o dia em que um deploy reinicia o processo no meio de um lote.
Nesse dia, o suporte abre um ticket perguntando por que um cliente foi cobrado duas vezes, e o log do worker não tem erro nenhum para explicar. O BullMQ fez o que a configuração mandava, e é por isso que o problema passa pelos testes e só aparece em produção.
Para entender o que acontece, reproduzi esse cenário de propósito num docker compose local, com um lote de cobranças recorrentes de um SaaS, e quebrei quatro coisas: a API que devolve 503, o worker que morre com job em andamento, a cobrança que sai duplicada por causa disso e o docker stop que corta o job no meio do deploy. Em cada falha, você vê o que o BullMQ faz por baixo e a correção no código, com o antes e o depois medidos no terminal.
No fim, você sai com retry configurado só para o que é falha temporária, um jeito de impedir que o mesmo job cobre duas vezes, um worker que para no deploy sem cortar nada e um checklist de seis itens para conferir no seu projeto ainda hoje. A última parte mostra quanto custa manter o Redis de pé em produção e uma alternativa para quem prefere não carregar essa estrutura.
Prefere o conteúdo em vídeo? Veja nosso vídeo sobre o tema, rodando os mesmos testes na prática:
NESTE ARTIGO
- O que o BullMQ faz com um job
- O cenário: 3.500 cobranças no dia 1
- Primeiro lote: sem retry e com um kill
- Retry com backoff e o erro que não melhora
- O worker morre no meio da cobrança
- Duas chaves contra a cobrança duplicada
- Parar o worker sem cortar a cobrança
- Checklist antes de ir para produção
- Quando o Redis cai
- Uma alternativa com execução durável
01
O que o BullMQ faz com um job
Antes de quebrar qualquer coisa, é bom ter claro onde o job fica enquanto o worker trabalha nele, porque é nesse intervalo que as cobranças repetidas nascem. O BullMQ é uma biblioteca de filas para Node que guarda os jobs no Redis. Quando o produtor chama queue.add, o job fica gravado lá até algum worker pegar, e a fila pode acumular três jobs ou três mil sem que o produtor precise esperar por isso.
Os workers rodam em processos separados do produtor, e cada um pega um job, processa e marca como concluído. Para processar mais rápido, você sobe mais workers ou aumenta a concorrência de cada um, que é a quantidade de jobs que o mesmo processo trata ao mesmo tempo.
A versão 6.0 saiu em 30 de julho de 2026 com backends plugáveis: o Redis continua como padrão, e o Postgres entrou como alternativa para quem não quer operar um Redis separado. A linha 6.3 começou em 26 de agosto e chegou à 6.3.17 em 18 de outubro, com correção saindo quase toda semana, e a licença continua MIT.
Os estados de um job
Todo job passa por uma sequência de estados: entra em wait esperando um worker, vai para active quando algum worker pega e, se o processamento termina bem, segue para completed. Ao entrar em active, o job ganha um lock, e esse lock está no centro de quase tudo que dá errado mais adiante.
Quando o processamento lança erro e ainda sobra tentativa, o job vai para delayed, espera o tempo do backoff e volta para wait para tentar de novo. Se as tentativas acabam, ele termina em failed.
Onde ele aparece em software B2B
Em software B2B, fila aparece em tudo que não pode rodar dentro da requisição do usuário: cobrança e chamada a gateway de pagamento, webhook de saída, sincronização com ERP, e-mail e notificação, importação de planilha com milhares de linhas, relatório e PDF que levam minutos e rotinas periódicas, que no BullMQ ficam nos Job Schedulers.
Fora do Node, o modelo se repete no Sidekiq (Ruby), no Celery (Python), no Hangfire (.NET), no Asynq (Go) e no Oban (Elixir), e os problemas deste texto aparecem em todos eles com outros nomes.
02
O cenário: 3.500 cobranças no dia 1
Para os testes, escolhi um job em que repetir custa caro: a cobrança recorrente do Prumo ERP, um SaaS de gestão que cobra 3.500 assinaturas no cartão no dia primeiro de cada mês. Uma cobrança duplicada aqui vira estorno, ticket de suporte e um cliente desconfiado do seu sistema.
Cada cobrança vira um job, como o da assinatura sub_0412, da Padaria Bom Grão, de R$ 189,90. O worker é o processo Node que pega esse job e chama o gateway, que aprova a cobrança e devolve um id como ch_7f2a.
Se o seu worker manda e-mail, sincroniza pedido com ERP ou dispara webhook, dá para trocar a cobrança pelo seu job em qualquer ponto do texto, porque as falhas e as correções são as mesmas.
Quatro containers num docker compose
api: o produtor, que enfileira as cobranças.redis: guarda a fila e o estado de cada job.worker: processa dez cobranças por vez.gateway-local: simula o gateway de pagamento. Ele leva 300 ms por cobrança, devolve 503 em 20% das chamadas e 402 para 12 cartões cancelados, aceita o headerIdempotency-Keye loga cada cobrança, o que permite contar as duplicadas no endpoint/duplicadas.
services:
  redis:
    image: redis:8-alpine
    command: ["redis-server", "--maxmemory-policy", "noeviction"]
  gateway-local:
    build: ./gateway-local
    environment:
      LATENCIA_MS: 300
      TAXA_503: 0.2
      CARTOES_CANCELADOS: 12
  api:
    build: .
    command: ["node", "produtor.js"]
    depends_on: [redis]
  worker:
    build: .
    command: ["node", "worker.js"]
    depends_on: [redis, gateway-local]
O Redis sobe com maxmemory-policy noeviction, então recusa escrita quando a memória enche em vez de apagar chave. Para fila, esse é o comportamento certo, porque com uma política de eviction o Redis pode apagar um job sem avisar ninguém. O gateway-local recebe a latência, a taxa de 503 e a quantidade de cartões cancelados por variável de ambiente, e api e worker usam a mesma imagem, cada um com o seu comando.
O produtor
import { Queue } from 'bullmq';
import IORedis from 'ioredis';

const connection = new IORedis('redis://redis:6379');
const cobrancas = new Queue('cobrancas', { connection });

const assinaturas = await carregarAssinaturasAtivas(); // 3.500
const competencia = '2026-10';

for (const a of assinaturas) {
  await cobrancas.add('cobrar', {
    assinaturaId: a.id,
    valor: a.valor,
    competencia,
  });
}
Na versão 6, o ioredis passou a ser dependência opcional, então quem usa Redis instala os dois pacotes, com npm i bullmq ioredis. A fila se chama cobrancas, o mesmo nome que o worker usa para consumir, e para cada assinatura ativa o produtor faz um add com o id da assinatura, o valor e a competência, ainda sem retry e sem chave.
O worker
import { Worker } from 'bullmq';
import IORedis from 'ioredis';

const connection = new IORedis('redis://redis:6379', {
  maxRetriesPerRequest: null,
});

const worker = new Worker('cobrancas', async (job) => {
  const { assinaturaId, valor } = job.data;
  const res = await fetch('http://gateway-local:4000/charges', {
    method: 'POST',
    headers: { 'content-type': 'application/json' },
    body: JSON.stringify({ assinaturaId, valor }),
  });
  if (!res.ok) throw new Error(`gateway ${res.status}`);
  return res.json();
}, { connection, concurrency: 10 });
O BullMQ exige maxRetriesPerRequest: null na conexão do worker e lança exceção se ela chegar com outro valor. Com null, o cliente continua tentando enquanto o Redis estiver fora, e o worker volta a processar assim que a conexão volta.
O worker chama o gateway com fetch e, se a resposta não for ok, lança um Error que manda o job para failed. Com concurrency: 10, ficam dez jobs em active ao mesmo tempo, e se o processo morrer são dez cobranças interrompidas.
03
Primeiro lote: sem retry e com um kill
O primeiro lote rodou com o código da seção anterior, ainda sem retry e sem chave, contra um gateway que devolve 503 em 20% das chamadas. Subi os quatro containers, acompanhei o log do worker e, com o lote andando, derrubei o worker com kill. Depois subi o worker de novo e esperei o lote terminar.
$ docker compose up -d --build
$ docker compose logs -f worker
worker | completed  sub_0001  ch_1a90
worker | failed     sub_0007  gateway 503
worker | completed  sub_0008  ch_1b47
worker | failed     sub_0977  gateway 402
$ docker compose kill worker
$ docker compose start worker
worker | stalled    sub_0412  voltou para wait
worker | completed  sub_0412  ch_9c1e
worker | lote concluído: 3.500 jobs
$ curl localhost:4000/duplicadas
["sub_0412","sub_0413","sub_0415","sub_0416",
 "sub_0418","sub_0419","sub_0420","sub_0421","sub_0422"]
Perto de 700 jobs foram para failed por causa do 503, cerca de 20% do lote. Os doze cartões cancelados estão no mesmo lugar, misturados com os 503, sem nenhuma distinção entre uma falha que passaria na tentativa seguinte e um cartão que nunca vai passar.
Já o /duplicadas mostra nove assinaturas cobradas duas vezes, das dez que estavam em active na hora do kill. A sub_0412 foi aprovada às 09:00:14 e de novo às 09:00:58, com o kill no meio, e o log do worker não registrou erro em nenhuma das duas cobranças.
Os dois problemas têm causas diferentes, e o retry resolve só o primeiro.
04
Retry com backoff e o erro que não melhora
Perto de 700 dos 712 jobs em failed foram parar lá no primeiro 503, porque sem retry a primeira falha já encerra o job. Só que o 503 é uma falha temporária: o gateway ficou fora por um instante, e a chamada seguinte tem boa chance de passar. Para esse tipo de erro, o BullMQ tenta de novo com attempts e espera entre as tentativas com backoff.
Com backoff exponencial e delay de 2.000 ms, a espera depois da falha número n é 2n−1 × 2.000 ms. Com cinco tentativas, as esperas ficam em 2, 4, 8 e 16 segundos, e a sub_0412 passa na quinta.
Com o 402 da sub_0977, mais tentativas não ajudam, porque o cartão foi cancelado e a resposta vai ser a mesma em qualquer tentativa. Repetir só gasta mais quatro chamadas ao gateway e atrasa em 30 segundos uma recusa que já estava decidida. Para esse caso o BullMQ tem o UnrecoverableError: o job que lança esse erro ignora o attempts e vai direto para failed.
await cobrancas.add('cobrar', dados, {
  attempts: 5,
  backoff: { type: 'exponential', delay: 2000 },
});import { Worker, UnrecoverableError } from 'bullmq';
// dentro do processador, depois do fetch
if (res.status === 402) {
throw new UnrecoverableError('cartão cancelado');
}
if (!res.ok) throw new Error(`gateway ${res.status}`);O produtor ganha attempts: 5 e backoff exponencial com delay de 2.000 ms. No worker, o 402 lança UnrecoverableError, e qualquer outro erro, como 503 e timeout, continua passando pelo backoff.
O lote de novo, com retry
O down -v remove os containers e os volumes, então o Redis volta vazio e o lote recomeça do zero.
$ docker compose down -v
$ docker compose up -d --build
$ docker compose logs -f worker
worker | sub_0128  503  tentativa 1 de 5 · nova em 2 s
worker | sub_0128  completed na tentativa 2
worker | sub_0733  503  tentativa 1 de 5 · nova em 2 s
worker | sub_0733  503  tentativa 2 de 5 · nova em 4 s
worker | sub_0733  completed na tentativa 3
worker | sub_0977  402  UnrecoverableError
worker | lote concluído: 3.500 jobs
worker | failed: 12 com 402, 1 com cinco 503
O failed caiu de 712 para 13, que são os doze cartões cancelados e uma cobrança que pegou 503 cinco vezes seguidas. Com 20% de falha por chamada, a chance de errar cinco vezes seguidas é 0,25, ou 0,032%, o que em 3.500 cobranças dá 1,1 job, exatamente o que apareceu.
05
O worker morre no meio da cobrança
O retry só entra quando o processamento lança erro, e nas nove duplicadas nenhuma chamada ao gateway deu erro: ele aprovou as duas cobranças de cada assinatura. Para entender de onde veio a segunda cobrança, o melhor é acompanhar um job só, a sub_0412, desde o momento em que ela sai de wait.
Às 09:00:14, um worker pega a sub_0412, que vai para active com um lock de 30 segundos, e chama o gateway, que aprova a cobrança ch_7f2a. Um segundo depois, antes de o worker marcar o job como concluído, o kill derruba o processo.
O job continua em active no Redis, só que ninguém renova o lock. Um worker vivo renovaria a cada 15 segundos, mas com o processo morto o lock vence às 09:00:45.
A cada 30 segundos, os próprios workers rodam uma checagem que procura jobs ativos com lock vencido. Às 09:00:58, essa checagem encontra a sub_0412 e devolve o job para wait, e é esse job devolvido que o BullMQ chama de stalled. O worker reiniciado pega o mesmo job e processa de novo, e o gateway cria outra cobrança, a ch_9c1e.
A sub_0412 foi cobrada duas vezes, e o BullMQ seguiu a regra dele à risca. A garantia que ele oferece é de pelo menos uma execução por job: se o worker morre depois da chamada ao gateway e antes de marcar o job como concluído, o job roda de novo.
Essa janela entre a chamada externa e o registro do resultado existe em qualquer sistema que tenta de novo, da fila mais simples a uma plataforma de execução durável. A página Garantias de execução, da documentação do skail (eu faço parte da skail), separa o que uma plataforma consegue garantir do que continua sendo responsabilidade do seu código, e a leitura serve para quem fica no BullMQ.
Os prazos que decidem isso
| CONFIGURAÇÃO | PADRÃO | O QUE FAZ |
|---|---|---|
lockDuration |
30 s | Duração do lock de cada job em active. Enquanto o lock vale, nenhum outro worker pega o job. |
lockRenewTime |
15 s | Intervalo em que o worker vivo renova o lock. O padrão é metade do lockDuration. |
stalledInterval |
30 s | Intervalo da checagem que procura locks vencidos e devolve esses jobs para wait. |
maxStalledCount |
1 | Quantas vezes o mesmo job pode voltar como stalled. Na segunda vez que travar, ele vai para failed. |
O mesmo problema aparece com o worker vivo, porque a renovação do lock roda no event loop do Node e um for síncrono de 40 segundos dentro do processamento impede a renovação. O lock vence, a checagem devolve o job para wait e outro worker processa a mesma cobrança enquanto o primeiro ainda está trabalhando nela.
06
Duas chaves contra a cobrança duplicada
A cobrança pode duplicar em dois pontos diferentes, e cada um pede uma chave: na fila, quando o mesmo job é enfileirado duas vezes, e no gateway, quando o mesmo job é executado duas vezes.
jobId: o mesmo job enfileirado duas vezes
O produtor pode rodar duas vezes no mesmo mês, por um deploy no meio do lote ou por um cron duplicado. Com um jobId montado a partir do id da assinatura e da competência, como cob-sub_0412-2026-10, o segundo add chega com um id que já existe na fila e é ignorado.
O jobId não resolve o kill, porque o job que volta como stalled é o mesmo job, com o mesmo id, e o BullMQ processa de novo do mesmo jeito.
Idempotency-Key: o mesmo job executado duas vezes
Para a execução repetida, a proteção precisa estar no gateway, e o worker manda o id do job no header Idempotency-Key, o mesmo que o Stripe usa. Na primeira chamada, o gateway cria a cobrança ch_7f2a e guarda a chave. Quando o job roda de novo e chama com a mesma chave, o gateway devolve a mesma ch_7f2a sem cobrar outra vez.
const chave = `cob-${a.id}-${competencia}`;
await cobrancas.add('cobrar', dados, {
  jobId: chave,
  attempts: 5,
  backoff: { type: 'exponential', delay: 2000 },
});const res = await fetch('http://gateway-local:4000/charges', {
method: 'POST',
headers: {
'content-type': 'application/json',
'Idempotency-Key': job.id,
},
body: JSON.stringify({ assinaturaId, valor }),
});O jobId não pode ter dois-pontos nem ser só número, e o BullMQ lança erro nos dois casos. Ele também só barra o segundo add enquanto o job existir no Redis, então com removeOnComplete o job concluído é apagado e o id fica livre de novo. A Idempotency-Key depende do outro lado e só protege se o serviço chamado reconhecer o header.
Quando o serviço não aceita chave, a saída é guardar no seu banco os efeitos já aplicados e consultar antes de chamar. O guia Como escrever commands idempotentes mostra esse padrão e o upsert por chave natural, e a mesma lógica vale dentro de um worker do BullMQ.
O kill de novo, com as duas chaves
$ docker compose down -v
$ docker compose up -d --build
$ docker compose kill worker
$ docker compose start worker
worker | stalled  sub_0412  voltou para wait
worker | stalled  sub_0413  voltou para wait
worker | mais 8 jobs stalled
gateway-local | replay  sub_0412 → ch_7f2a
gateway-local | replay  sub_0413 → ch_7f31
gateway-local | 10 replays, nenhuma cobrança nova
$ curl localhost:4000/duplicadas
[]
Os dez jobs que estavam em active voltam como stalled em até um minuto, o gateway-local loga um replay para cada um com o id da cobrança original, e o /duplicadas volta vazio.
07
Parar o worker sem cortar a cobrança
O kill que usei até aqui simula uma queda, mas no dia a dia quem derruba o worker é o deploy: o container recebe um docker stop, e sem nenhum ajuste ele também corta as cobranças em andamento. O docker stop manda SIGTERM para o processo de PID 1, espera 10 segundos e, se o processo continuar de pé, manda SIGKILL.
Sem handler, o Node rodando como PID 1 ignora o SIGTERM, porque o Linux não aplica a ação padrão dos sinais ao PID 1 e o processo só para se tratar o sinal por conta própria. Passados os 10 segundos, o Docker manda SIGKILL e corta a cobrança em andamento, que volta como stalled mais tarde e repete tudo que está na seção 5.
Com os ajustes, o tini fica como PID 1 e repassa o SIGTERM para o Node, e o handler chama worker.close(). O worker para de pegar job novo, espera a cobrança ativa terminar e sai com exit 0 em 0,4 segundo, dentro do prazo de 30 segundos.
const encerrar = async (sinal) => {
  console.log(`${sinal} recebido, fechando o worker`);
  await worker.close();
  process.exit(0);
};
process.on('SIGTERM', () => encerrar('SIGTERM'));
process.on('SIGINT', () => encerrar('SIGINT')); worker:
build: .
command: ["node", "worker.js"]
init: true
stop_grace_period: 30sNo worker, o handler de SIGTERM e SIGINT chama worker.close() e só depois process.exit, e no compose o init: true coloca um init mínimo como PID 1 para repassar os sinais ao seu processo. Um detalhe que pega muita gente é o CMD npm start na forma shell do Dockerfile, porque nesse caso quem recebe o sinal é o /bin/sh, e ele não repassa.
O stop_grace_period subiu de 10 segundos, que é o padrão, para 30, porque ele precisa ser maior que a cobrança mais lenta.
# antes: sem handler e sem init
$ time docker compose stop worker
real    0m10.214s
jobs stalled: 10
# depois: com os três ajustes
$ docker compose up -d --build worker
$ time docker compose stop worker
worker | SIGTERM recebido, fechando o worker
real    0m0.412s
jobs stalled: 0
Antes dos ajustes, o stop levou 10,2 segundos e os dez jobs ativos viraram stalled. Depois, o log mostra o SIGTERM recebido e o stop termina em 0,4 segundo, sem job stalled e sem cobrança cortada.
08
Checklist antes de ir para produção
Abra o worker do seu projeto e confira estes seis itens, na ordem em que apareceram no texto. Cada um fecha uma das falhas que reproduzimos.
attempts e backoff exponencial para 5xx e timeout.UnrecoverableError para o que não melhora tentando de novo, como cartão cancelado.jobId na fila e Idempotency-Key no serviço chamado.worker.close(), init: true e stop_grace_period.noeviction no servidor e maxRetriesPerRequest: null no worker.09
Quando o Redis cai
Num outro dia primeiro, o Redis caiu às 09:00:20 e voltou com zero jobs, e nenhum dos ajustes feitos no worker até aqui ajudou. O worker perdeu a conexão e parou, a api recebeu ECONNREFUSED ao tentar enfileirar, e o container do Redis foi recriado sem volume.
O lote do dia primeiro sumiu sem nenhum erro no código, porque a fila inteira dependia de um processo só. Para isso não acontecer, entram na conta:
- Persistência. Com AOF e
appendfsync everysec, um crash perde até um segundo de escrita, enquanto só com RDB ele perde tudo desde o último snapshot, o que costuma significar minutos. - Réplica e failover, com Sentinel ou réplica gerenciada. A replicação do Redis é assíncrona, então um failover pode perder um job que o produtor já recebeu como gravado.
- Cluster. A fila precisa de hash tag no prefixo, como
prefix: '{cobrancas}', senão as chaves da mesma fila caem em slots diferentes e os comandos que mexem em várias chaves de uma vez falham. - Monitoramento de fila parada,
failed, stalled e memória, com alguém de plantão para receber o alerta no dia primeiro às 9 da manhã. - Deploy e upgrade do Redis e dos workers sem cortar job.
O custo que mais pesa fica com o time: alerta, plantão, upgrade, teste de failover e o postmortem do dia em que os jobs sumiram. Para um time de quatro a seis pessoas sem SRE, isso vira horas tiradas do produto todo mês.
10
Uma alternativa com execução durável
Tudo que montamos até aqui (Redis com réplica, workers, lock, stalled, backoff, alerta e grace period) existe para uma cobrança terminar uma vez só. Uma alternativa é rodar esse fluxo numa plataforma de execução durável, em que a cobrança vira um método na sua aplicação, lido de cima para baixo, e a plataforma guarda o estado da execução e retoma de onde parou quando a aplicação cai.
Eu faço parte da skail, que é uma plataforma de execução durável, então leve isso em conta no que vem agora.
A cobrança no skail
No exemplo de cobrança da documentação do skail, a função CobrarCartao é uma SkailFunction que orquestra os passos, com a régua de tentativas num array: na hora, depois de cinco minutos, depois de uma hora e depois de seis horas. Entre uma tentativa e outra, a execução hiberna sem ocupar thread nem processo.
[SkailFunction]
public async SkailTask<ResultadoCobranca> CobrarCartao(Guid faturaId)
{
    var backoff = new[]
    {
        TimeSpan.Zero,
        TimeSpan.FromMinutes(5),
        TimeSpan.FromHours(1),
        TimeSpan.FromHours(6)
    };

    foreach (var espera in backoff)
    {
        await SkailTask.Delay(espera);

        var resultado = await TentarCobranca(faturaId);

        if (resultado.Sucesso)
        {
            await ConfirmarPagamento(faturaId, resultado.TransacaoId);
            return ResultadoCobranca.Sucesso;
        }

        if (resultado.ErroPermanente)
        {
            await MarcarComoRecusada(faturaId, resultado.Motivo);
            return ResultadoCobranca.Recusada;
        }
    }

    await EscalarParaCobrancaManual(faturaId);
    return ResultadoCobranca.Pendente;
}

[SkailCommand]
public async SkailTask<ResultadoTentativa> TentarCobranca(Guid faturaId)
{
    var fatura = await _faturas.Obter(faturaId);
    // recusa do cartão volta no resultado;
    // 503 e timeout lançam exceção e o skail tenta de novo
    return await _gateway.Cobrar(fatura.ClienteId, fatura.Valor,
        idempotencyKey: $"cob-{faturaId}");
}
Quem fala com o gateway é o TentarCobranca, um SkailCommand, que é onde fica a operação de I/O, e um command que já gravou resultado não roda de novo quando a função é retomada.
Se a resposta for erro permanente, como cartão cancelado, a função marca a fatura como recusada e devolve, cumprindo com um if no meio da regra de negócio o papel que o UnrecoverableError tinha no worker.
O corpo do TentarCobranca não está na documentação, e eu completei para mostrar onde entra a Idempotency-Key. Ela cobre a queda durante a chamada ao gateway: se a aplicação cair antes de o resultado ser gravado, o command roda de novo na retomada, e a chave impede a segunda cobrança.
A mesma cobrança no Monitor
No Monitor do skail, a execução da CobrarCartao para a fatura fat_0412, da mesma Padaria Bom Grão, começa às 10:00:00 de 1º de novembro. O Delay de zero é o primeiro passo, e logo depois vem o TentarCobranca, que na primeira tentativa pega o gateway com 503.
Como é falha técnica, o command lança exceção e o skail tenta de novo sozinho, sem linha nova na execução: só o campo Tentativas do passo sobe. Na quarta tentativa, às 10:00:05, o gateway aprova a transação tx_8812.
Às 10:00:06, a aplicação cai antes do ConfirmarPagamento, no mesmo ponto em que o docker kill derrubou o worker na seção 5, e quando ela volta, às 10:00:41, o skail retoma a execução. A função roda de novo desde o começo, mas o TentarCobranca já está no histórico: abrindo o passo, a saída gravada aparece com a mesma tx_8812, e o gateway não é chamado outra vez. Só o ConfirmarPagamento roda, e a cobrança termina com Sucesso e uma transação só.
O array de cinco minutos, uma hora e seis horas serve para outro caso: quando o gateway recusa sem erro permanente, como saldo insuficiente. A falha técnica fica com a nova tentativa automática do command, e a recusa de negócio fica com a régua escrita no código.
No dia primeiro são 3.500 execuções dessas, uma por fatura, e a lista do Monitor filtrada pelo workload faturamento mostra o que terminou, o que está aguardando a próxima tentativa do array e o que está parado há mais tempo. Se um passo falhar de vez, dá para abrir a execução e depurar ou tentar o passo de novo.
O que muda e o que você passa a respeitar
O fluxo inteiro fica num método, lido como um monolito, com retry, espera e erro permanente no mesmo lugar da regra de negócio. Se a aplicação cair, a execução retoma de onde parou, sem a fila, o lock e o stalled que montamos.
Em troca, você passa a seguir duas regras. O corpo da function precisa produzir sempre o mesmo resultado, então relógio, banco e chamada HTTP ficam em commands, e quem muda o código com execuções em andamento publica uma versão nova do workload e mantém a antiga até elas terminarem.
A documentação traz o exemplo de faturamento com a cobrança, a régua de cobrança da fatura e a assinatura mensal: Faturamento completo: cobrança, recorrência e split de pagamento.
FAQ
Perguntas frequentes
Por que o BullMQ processou o mesmo job duas vezes?
O BullMQ garante pelo menos uma execução por job. Se o worker morre depois de chamar o serviço externo e antes de marcar o job como concluído, o lock vence em 30 segundos, a checagem de stalled devolve o job para wait e um worker processa de novo. A proteção contra a cobrança repetida fica no serviço chamado, com uma chave de idempotência.
Qual é o lockDuration padrão do BullMQ?
São 30 segundos, com renovação do lock a cada 15 segundos, que é metade do lockDuration. A checagem de stalled roda a cada 30 segundos, e o maxStalledCount padrão é 1.
O jobId evita job duplicado no BullMQ?
Evita o segundo add com o mesmo id enquanto o job existir no Redis, mas não evita a reexecução de um job que voltou como stalled, porque é o mesmo job. Para esse caso, mande uma Idempotency-Key para o serviço chamado.
Como fazer graceful shutdown de um worker BullMQ no Docker?
Trate SIGTERM e SIGINT chamando worker.close() antes de process.exit, use init: true no compose para o sinal chegar ao Node e ajuste o stop_grace_period, que no Docker tem padrão de 10 segundos, para mais que o job mais lento.
Quando usar UnrecoverableError no BullMQ?
Quando tentar de novo não muda a resposta, como num 402 de cartão cancelado. O job que lança esse erro ignora o attempts e vai direto para failed, sem passar pelas esperas do backoff.
PRÓXIMO PASSO
Por onde começar
Se você já roda BullMQ na sua empresa, comece pelo checklist da seção 8 e depois repita o teste da seção 5 no seu ambiente de homologação: um docker compose kill no worker com o lote andando e uma contagem das chamadas repetidas no serviço de destino. O resultado mostra rápido quais itens do checklist estão faltando.
Se a alternativa com execução durável fizer sentido para o seu caso, a seção Fundamentos da documentação do skail explica execução durável, replay, retry e versionamento na ordem em que um conceito depende do outro.
Para ver tudo isso acontecendo passo a passo, com as animações do lock e do stalled, assista ao vídeo BullMQ na prática.