Execução durável é a capacidade de registrar o progresso de um processo e retomá-lo após falhas ou pausas. O sistema preserva informações sobre as etapas executadas e usa esse histórico para continuar o trabalho, inclusive em outro servidor.
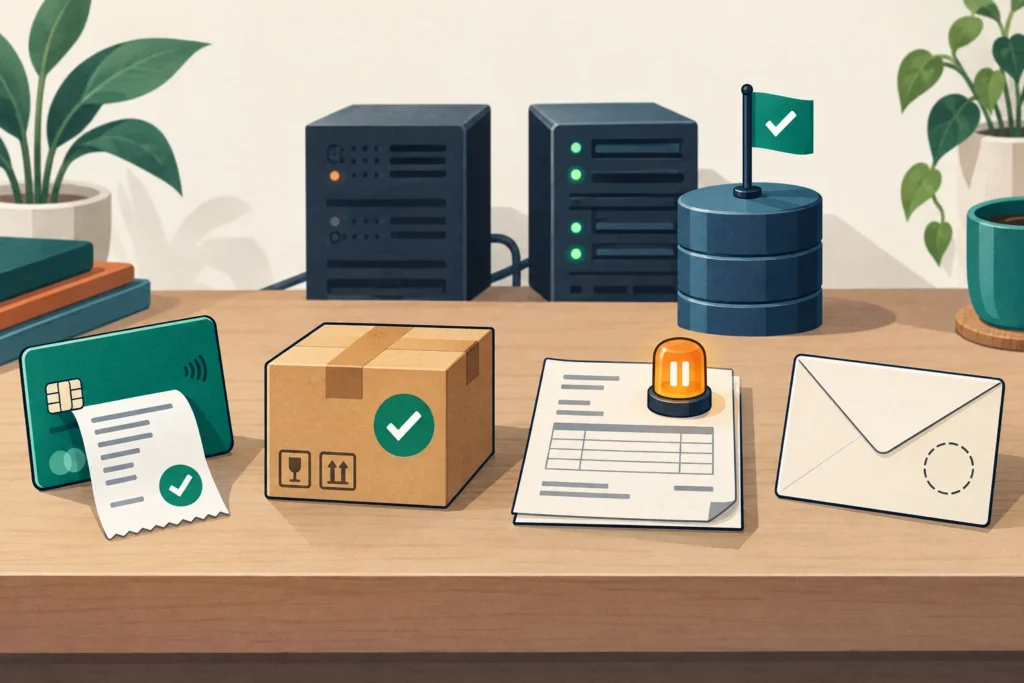
Imagine uma compra com quatro etapas: cobrar o cliente, reservar o estoque, emitir a nota fiscal e enviar um e-mail de confirmação.
O pagamento foi aprovado. O estoque está reservado. Na hora de emitir a nota, a SEFAZ fica indisponível. Ou o contêiner que executava o processo é encerrado durante um deploy.
O cliente já pagou. O pedido precisa continuar. Reiniciar tudo sem consultar o progresso pode gerar uma segunda cobrança ou outra reserva de estoque.
A execução durável permite tratar essa continuidade no próprio fluxo da aplicação. Seu funcionamento combina registro de progresso, replay, retry, idempotência, determinismo, hibernação e paralelismo durável.
Para quem prefere o formato em vídeo, a explicação completa está logo abaixo.
Neste artigo
- 1. Registro de progresso: o que já aconteceu precisa ficar salvo
- 2. Replay: reconstruir a execução usando o histórico
- 3. Retry: tentar novamente a etapa que falhou
- 4. Idempotência: repetir a chamada sem duplicar a cobrança
- 5. Determinismo: preservar as decisões durante o replay
- 6. Hibernação: aguardar uma aprovação sem manter a execução ativa
- 7. Paralelismo durável: esperar todas as respostas ou o primeiro evento
- Como os sete conceitos se combinam no pedido
- Perguntas frequentes sobre execução durável
- Por onde começar na sua aplicação
1. Registro de progresso: o que já aconteceu precisa ficar salvo
O registro de progresso guarda as informações necessárias para recuperar uma execução. Isso inclui a identificação das atividades, os dados usados e os resultados obtidos.
No exemplo da compra, o sistema precisa saber que a cobrança foi aprovada e qual autorização o gateway retornou. Também precisa identificar a reserva de estoque já realizada.
Essas informações devem sobreviver à queda do processo. Se estiverem apenas na memória do contêiner, desaparecem quando ele é encerrado.
Pense no checkpoint de um jogo. Você salva o avanço em determinados pontos e, quando perde, volta ao último ponto salvo. Em software, esses pontos correspondem ao progresso persistido da execução.
Existe uma janela que exige cuidado: o serviço externo pode concluir uma operação antes que a aplicação registre o resultado. Uma cobrança aprovada seguida de uma falha na comunicação deixa o sistema sem confirmação. A idempotência, que veremos adiante, ajuda a tratar esse caso.
2. Replay: reconstruir a execução usando o histórico
Replay é a reconstrução do estado de uma execução a partir dos eventos e resultados já registrados.
Imagine que o servidor A caiu depois de cobrar o cliente e reservar o estoque. O servidor B assume o processamento. Ao consultar o histórico, encontra essas duas atividades concluídas e recupera seus resultados.
O trabalho pendente começa na emissão da nota fiscal.
Em mecanismos baseados em replay, o código de orquestração pode percorrer novamente etapas anteriores. As atividades concluídas e registradas devolvem seus resultados salvos, sem repetir as chamadas externas.
Essa distinção importa: se o gateway cobrou, mas a confirmação não entrou no histórico, o replay sozinho não consegue afirmar que a cobrança terminou. O tratamento da operação precisa considerar essa incerteza.
Para aprofundar o tema, consulte a página sobre execução durável na skail.
3. Retry: tentar novamente a etapa que falhou
Retry é uma nova tentativa de executar uma operação após uma falha. No pedido, pode ser uma nova chamada ao serviço de emissão de notas depois de uma indisponibilidade temporária.
Uma operação pode falhar três vezes e funcionar na quarta tentativa. Entre as tentativas, o sistema pode aplicar um intervalo crescente, chamado exponential backoff.
Um exemplo ilustrativo seria esperar 1 segundo antes da segunda tentativa, 2 segundos antes da terceira e 4 segundos antes da quarta. Os intervalos e limites dependem do serviço e da necessidade do processo.
Uma política de retry precisa definir quais erros permitem nova tentativa, quanto esperar e quando parar. Uma indisponibilidade temporária pode justificar retry. Um dado obrigatório ausente exige correção antes de tentar novamente.
Replay e retry podem participar da mesma recuperação: o replay reconstrói o fluxo até o ponto pendente; o retry tenta executar uma atividade que falhou.
4. Idempotência: repetir a chamada sem duplicar a cobrança
Uma operação é idempotente quando repeti-la preserva o mesmo efeito de executá-la uma vez. A requisição pode chegar novamente. O efeito de negócio precisa permanecer consistente.
Considere esta sequência:
- A aplicação solicita uma cobrança.
- O gateway aprova e cobra o cliente.
- A resposta se perde na rede.
- A aplicação não recebe a confirmação e tenta novamente.
Sem um mecanismo de proteção, a segunda chamada pode gerar outra cobrança.
Uma chave de idempotência identifica a operação lógica. Em um exemplo simplificado, a cobrança do pedido 123 poderia usar pedido-123-cobranca-1. Todas as tentativas dessa mesma cobrança reutilizam a chave, dentro do escopo definido pelo serviço.
O gateway reconhece a repetição e pode devolver o resultado já registrado. Esse comportamento depende do suporte do serviço à idempotência e das regras que ele define para os parâmetros e a retenção das chaves.
Gerar uma chave nova em cada retry impede que o serviço identifique a repetição. Reutilizar uma chave para cobranças diferentes também é incorreto. O prazo de retenção da chave deve ser considerado quando o processo pode ficar parado por muito tempo.
No exemplo da cobrança, a aplicação fez duas chamadas, mas o cliente recebeu apenas um débito. Ao avaliar a confiabilidade de uma integração, precisamos separar essas duas contagens: quantas vezes a operação pode ser executada e quantas vezes seu efeito pode ocorrer.
O que significam at-most-once, at-least-once e exactly-once?
Esses termos descrevem garantias de entrega ou processamento. O significado exato depende da camada analisada. Para consultar durante o desenho de uma integração:
| Garantia | Significado no escopo definido | Consequência prática |
|---|---|---|
| At-most-once | A operação ocorre zero ou uma vez. | Pode deixar de acontecer. |
| At-least-once | A operação pode ocorrer uma ou mais vezes. | Precisa tolerar repetições; a garantia depende das condições de entrega e recuperação. |
| Exactly-once | O processamento ou efeito ocorre uma única vez no escopo garantido. | Exige conhecer os limites dessa garantia e como ela é implementada. |
Um motor durável pode registrar uma conclusão única enquanto a atividade é executada mais de uma vez. Nesse cenário, atividades idempotentes permitem tratar novas tentativas sem repetir o efeito de negócio.
Por isso, a existência de replay ou de uma chave no pedido não estabelece, sozinha, uma garantia universal de exactly-once entre serviços. O efeito externo depende também do contrato e da implementação do destino.
5. Determinismo: preservar as decisões durante o replay
Determinismo, nesse contexto, significa que a orquestração toma decisões compatíveis com o mesmo histórico ao reconstruir uma execução.
Considere uma regra de aprovação de cotações com limite de 5 milhões. Se o valor ultrapassar esse limite, a execução segue o caminho A. Se for menor ou igual, segue o caminho B.
Quando o valor consultado fica registrado, o replay reutiliza esse dado. A mesma execução mantém a decisão original, mesmo que o banco tenha recebido atualizações depois.
Consultar novamente a fonte durante o replay poderia produzir outro valor e mudar o caminho no meio do processo.
O exemplo das 9h59
Uma transação iniciada às 9h59 segue uma regra válida antes das 10h. Depois de alguns passos, a aplicação cai. A retomada acontece após as 10h.
Se o código consultar diretamente o relógio atual para refazer a decisão, poderá selecionar outra regra. Para preservar a decisão original, precisa usar o horário registrado ou um recurso de tempo compatível com replay fornecido pelo motor durável.
A decisão muda durante a reconstrução da mesma execução.
A decisão original é preservada durante a reconstrução.
O mesmo cuidado se aplica a consultas a APIs, arquivos, bancos de dados e chamadas a LLMs. Os resultados podem mudar entre chamadas. Nos pontos já concluídos, a reconstrução deve usar os valores registrados.
Os detalhes variam entre implementações. Em motores baseados em replay, as APIs do framework ajudam a preservar a consistência do tempo, das atividades e de outras operações, conforme os recursos oferecidos por cada implementação.
6. Hibernação: aguardar uma aprovação sem manter a execução ativa
Hibernação é a suspensão durável de um fluxo enquanto ele aguarda um evento ou prazo. O sistema registra onde parou e o que precisa acontecer para continuar.
Imagine um pedido que depende da aprovação de uma pessoa. A resposta pode chegar por uma tela, um e-mail ou uma integração com outro sistema.
O fluxo registra essa espera e libera os recursos de execução que o motor permite liberar. Quando recebe o evento correspondente, recupera o estado e continua. A retomada pode acontecer em outro servidor, horas ou dias depois.
Aguardando aprovação. Estado salvo.
A infraestrutura que armazena o estado e recebe eventos continua existindo. A execução suspensa pode aguardar sem manter uma thread bloqueada durante todo esse período.
Na aplicação, o evento de aprovação precisa identificar a execução correta. Também é necessário definir o que acontece em caso de rejeição ou vencimento do prazo.
Veja também o tópico de hibernação e retomada na documentação da skail.
7. Paralelismo durável: esperar todas as respostas ou o primeiro evento
Paralelismo durável coordena atividades concorrentes e preserva o progresso necessário para continuar após falhas. Dois padrões de espera são úteis aqui: aguardar todas as respostas necessárias ou avançar quando o primeiro evento ocorrer.
Quando todas as cinco aprovações são necessárias
Um processo depende da aprovação de cinco pessoas. As solicitações podem ser feitas em paralelo, e cada resposta fica registrada.
Se três pessoas já aprovaram quando o servidor cai, a recuperação preserva essas três respostas. O processo segue aguardando as duas restantes.
Ele avança quando as cinco aprovações exigidas estiverem registradas. Uma rejeição precisa seguir uma regra de negócio definida. Esse tipo de distribuição e reunião de resultados é conhecido como fan-out/fan-in.
Quando vale o primeiro evento: assinatura ou 30 dias
Em um período de avaliação, o sistema pode aguardar dois acontecimentos: a confirmação de uma assinatura paga e o fim de um prazo de 30 dias.
Se a confirmação chegar primeiro, o fluxo mantém o acesso conforme a assinatura. Se o prazo vencer primeiro, segue a regra de encerramento da avaliação.
O temporizador precisa sobreviver à queda do processo. Depois que um evento determina a decisão, o sistema também precisa tratar o outro caso ele chegue mais tarde, sem aplicar uma ação incompatível com o estado atual da assinatura.
Como os sete conceitos se combinam no pedido
Voltando à compra, o sistema registra o pagamento aprovado e a reserva de estoque. A emissão da nota falha por indisponibilidade temporária. A política de retry agenda uma nova tentativa.
Se o servidor cair nesse intervalo, outro servidor recupera o histórico por replay. As etapas concluídas usam seus resultados registrados. As operações sujeitas a repetição mantêm suas chaves de idempotência.
As decisões do fluxo preservam os dados históricos necessários. Se houver uma aprovação humana, a execução aguarda de forma durável. Se houver verificações independentes, elas podem avançar em paralelo.
Quando a emissão da nota é confirmada, o fluxo segue para o envio do e-mail. Cada integração precisa tratar também suas próprias repetições e falhas.
Perguntas frequentes sobre execução durável
Qual é a diferença entre replay e retry?
Replay reconstrói uma execução usando o histórico salvo. Retry faz uma nova tentativa de uma operação após uma falha. Uma recuperação pode precisar dos dois mecanismos.
Execução durável impede qualquer cobrança duplicada?
O histórico permite reaproveitar cobranças cuja conclusão foi registrada. Se uma cobrança acontecer e sua resposta se perder, será necessário tratar a incerteza com recursos como idempotência ou consulta ao serviço de pagamento. As garantias dependem da integração.
Um processo pode continuar em outro servidor?
Sim, quando o motor durável permite recuperar a execução a partir do estado persistido e os recursos necessários estão disponíveis. O progresso precisa estar acessível após a perda do servidor original.
Como a execução durável ajuda agentes de IA?
Ela pode preservar resultados de ferramentas e chamadas a modelos, permitir a retomada após falhas e sustentar esperas por aprovação humana. Uma resposta de LLM já registrada pode ser reutilizada durante o replay, preservando a decisão daquele ponto do fluxo.
Por onde começar na sua aplicação
Escolha um processo que atravesse mais de um serviço. Marque as etapas que alteram dados externos, como cobrança, reserva de estoque e emissão de nota.
Para cada uma, responda: qual resultado comprova a conclusão? Onde ele fica salvo? O que acontece se a resposta se perder? Como identificar uma tentativa repetida?
Essas respostas ajudam a definir os pontos de recuperação e as garantias que cada integração precisa oferecer.
Para continuar, explore os conceitos da plataforma e as funcionalidades da skail.