TL;DR
- A crise — a OpenClaw pediu desculpas oficialmente em maio de 2026 e priorizou estabilidade acima de novas features. O problema não estava no modelo raciocinar mal.
- A falha real — a camada de execução perdeu conexão no meio de tarefas de vários passos: tokens velhos, OAuth expirado durante a execução, estado de gateway. Quando isso acontece numa ação externa, o agente deixa trabalho pela metade.
- A camada que falta — execução durável: retoma do checkpoint depois de uma queda, torna a ação irreversível idempotente, sabe compensar. Abaixo estão o diagnóstico, o código em C# real e um trace de uma execução sobrevivendo à queda do gateway (skail como uma implementação).
Um agente estava no quarto passo de sincronizar o calendário de um cliente com um sistema de agendamento externo. Aí o token OAuth expirou no meio de uma chamada e o gateway derrubou a conexão. O que aconteceu, em ordem:
- Ele já tinha lido as duas agendas e resolvido os conflitos.
- Começou a gravar os novos eventos via API. Metade entrou; a outra metade, não.
- Ao voltar, não tinha memória de onde parou.
- Reabriu a tarefa do zero, releu as agendas agora inconsistentes e propôs criar de novo eventos que já existiam.
Ninguém aqui escreveu um prompt ruim. O modelo raciocinou bem em cada passo isolado. O que quebrou foi tudo o que acontece entre os passos.
Qual camada falhou
Cenas como essa são exatamente o que lotou os relatos de campo da OpenClaw até isso virar uma crise pública de confiabilidade. A cena da abertura é um composto desses relatos, não um incidente único; cada peça dela, porém, é literal.
A OpenClaw não morreu. O que ela viveu foi essa crise por dentro: um pedido de desculpas oficial em 5 de maio de 2026 que priorizou estabilidade: enxugar o core, mover os plugins opcionais para um hub à parte, prometer suporte de longo prazo.
Vale olhar para o que as correções de julho miraram, porque elas apontam o dedo com precisão. Nenhum desses é um problema de raciocínio:
- Estado do gateway
- Confiabilidade de relay
- Desconexões no Android
- Refresh tokens de OAuth travados
O padrão mais custoso é este: o agente não consegue manter conexão com o gateway, com os canais ou com o provedor.
O erro não fica onde nasceu. Ele viaja pela trajetória inteira até bater numa ação irreversível:
- um arquivo gravado
- uma mensagem que já foi enviada
- o registro que apareceu no sistema do cliente
O OpenClawBench cataloga exatamente isso sob o nome de “anomalias de process-side em trajetórias de execução de agentes reais”: defeitos no processo de execução em si, distintos da qualidade da resposta.
E há um agravante temporal. Os agentes ficam menos confiáveis depois de uso prolongado, quando conexões acumulam estado velho e tokens vencem sem ninguém perceber.
A camada que falta é execução durável
Repare no que todos esses sintomas têm em comum: nenhum deles vive dentro do modelo. Todos vivem entre os passos, na infraestrutura que segura a tarefa de pé. Esse problema já tem nome em sistemas de backend: execução durável.
É uma forma agnóstica de fornecedor de rodar uma tarefa de vários passos de modo que o progresso sobreviva à máquina que a executa. Três propriedades fazem o trabalho:
- Retomada por checkpoint. Cada passo concluído é persistido antes do próximo começar. Se o gateway cai no passo quatro, o processo retoma dali mesmo, sem recomeçar. O agente da cena teria reaberto a tarefa sabendo quais eventos já entraram.
- Idempotência na ação irreversível. A chamada externa que grava, envia ou cria carrega uma chave que o outro lado reconhece. Repetir a chamada depois de uma queda não duplica o efeito: o provedor vê a mesma chave e devolve o resultado que já existia. É assim que uma retomada deixa de ser perigosa.
- Compensação. Quando um passo tardio falha de forma definitiva, a camada consegue desfazer os efeitos dos passos anteriores em vez de deixar meio-caminho gravado no mundo. Sem ela, os eventos já gravados no passo cinco continuam lá mesmo quando o passo seis falha para sempre.
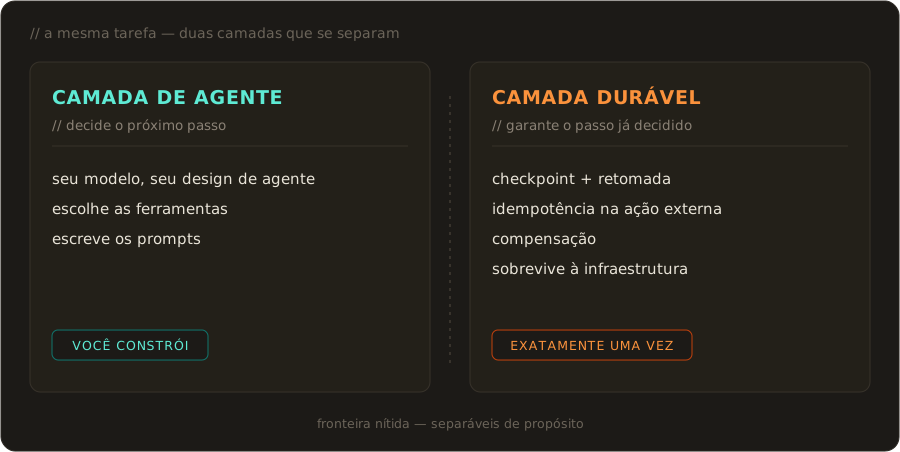
Tão importante quanto é o que essa camada não faz:
- Não escolhe as ferramentas nem escreve os prompts.
- Não decide o próximo passo. Essa é a camada de agente, e quem a constrói é você.
- Só garante que, uma vez decidido um passo, ele aconteça exatamente uma vez e sobreviva à infraestrutura.
As duas são separáveis de propósito.
Como isso fica no código
É essa camada que roda a nossa própria máquina de conteúdo: estes posts são produzidos por agentes duráveis, na mesma infraestrutura. Numa ocasião, um replay durante o disparo em andamento do escritor recontou um passo e custou cerca de 1,5x em processamento naquele trecho. Corrigimos com um lockfile e idempotência. Foi custo desperdiçado, não um resultado errado: a durabilidade preservou a correção, a economia veio depois.
Para tornar concreto, o código abaixo usa o skail, a implementação que conhecemos por dentro porque a nossa própria máquina roda nela. O runtime persiste cada passo e, depois de uma queda, retoma a execução a partir do último ponto salvo. Você marca a orquestração com [SkailFunction] e cada efeito externo com [SkailCommand].
Dois detalhes carregam mais peso do que parecem:
- Ler o relógio é efeito colateral, então sai de um
[SkailCommand](StampCompletedAtAsync), nunca solto no corpo do[SkailFunction]. Durante uma retomada o corpo é reexecutado; umDateTime.UtcNowinline devolveria um instante novo a cada passagem e faria o runtime divergir do histórico que gravou. Dentro do comando, o valor é gravado uma vez e devolvido do log. A mesma regra cobre qualquer leitura não-determinística: relógio, random, ID gerado. - A chave de idempotência (
ev.StableHash) é derivada do conteúdo do próprio evento, então a mesma tarefa produz a mesma chave em toda retomada.
Veja a cena da abertura rodando sob essa camada, com o gateway caindo no meio:
O evento ev-a1, que já tinha entrado no passo ⑤, não foi recriado na retomada: o checkpoint já o marcava como feito.
A ação que estava em voo quando o token expirou, ev-b2, foi redisparada com a mesma chave, então o provedor não gerou um duplicado. É o mesmo tipo de falha da cena inicial, sem o rastro de trabalho pela metade.
Quando você não precisa disso
Nem toda tarefa merece essa camada. Ela vira peso morto quando o trabalho é simples:
- Só leitura e resposta — um agente que resume um documento ou classifica um ticket e devolve o texto não tem efeito irreversível para proteger. Se ele cai, você roda de novo e pronto.
- Chamada única — sem passo intermediário com estado no mundo externo, não há checkpoint que faça diferença.
- Ação já idempotente e tarefa curta — se o provedor já trata a repetição do lado dele e uma retentativa simples cobre o caso, um runtime durável é peso que você carrega sem usar.
A conta muda quando três coisas aparecem juntas:
- vários passos;
- um efeito externo que você não quer duplicar nem deixar pela metade;
- execuções longas o suficiente para que uma queda de gateway seja questão de quando, não de se.
FAQ
Isso quer dizer que a OpenClaw está acabada?
Não. Ela é mantida e as correções de julho de 2026 atacam justamente o estado de gateway e os tokens travados. A crise mostrou onde a fronteira dói para o setor inteiro. Nenhum framework falhou sozinho.
A camada durável melhora o raciocínio do agente?
Não é o objetivo dela. Ela não escolhe passos nem escreve prompts; garante que o passo já decidido aconteça uma vez e sobreviva a uma queda. A qualidade das decisões continua sendo trabalho do seu modelo e do seu design de agente.
Preciso do skail para ter isso?
Não. skail é uma implementação da camada de execução durável. O padrão que importa é checkpoint, idempotência e compensação, e você pode obtê-lo por outros caminhos. Os exemplos aqui usam a API do skail porque é a que conhecemos por dentro.
O que fica
Um agente de vários passos é, no fundo, um processo de longa duração que toca sistemas externos. Processos assim sempre precisaram de execução durável; a novidade é só que agora quem os dirige é um modelo.
A crise da OpenClaw tornou essa velha exigência visível mais cedo do que o normal. Trate a execução como uma camada de primeira classe, separada do agente: as anomalias de process-side passam a aparecer no log como passos retomados, e o agente segue de onde parou.