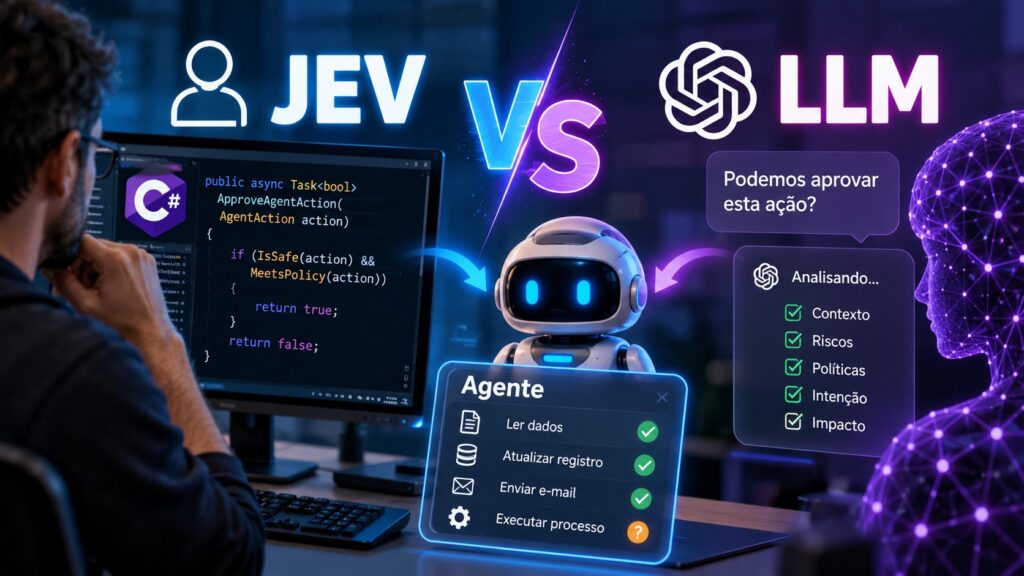
Um agente que executa ações precisa decidir, a cada mensagem, se entendeu o pedido e se o cliente autorizou. Testamos essas decisões com o GPT-5.4 mini e com o Jev num agente que emite e cancela NFS-e.
O cliente escreve “preciso anular aquela nota da Beta”. O agente propõe cancelar a nota 3350, de R$ 370,00, e pede confirmação. O cliente responde “manda ver”. Se o agente entender errado, cancela uma nota fiscal sem autorização, e cancelamento não tem volta.
Foram 82 casos rotulados à mão, com o mesmo catálogo de intenções nos dois lados. O acerto ficou igual. Mudaram o tempo, o custo e o quanto dá para confiar na confiança que cada modelo devolve.
Para quem prefere o formato em vídeo, a explicação completa está logo abaixo.
Neste artigo
- 1. O Jev em uma chamada
- 2. A mesma decisão com LLM e com Jev
- 3. Confiança escrita pelo modelo e confiança calibrada
- 4. Três casos em que os dois discordaram
- 5. Trocar sem risco: modo sombra e fallback
- 6. A decisão dentro de um fluxo durável no skail
- 7. Os números da rodada
- Perguntas frequentes
- Por onde começar no seu agente
1. O Jev em uma chamada
O Jev, da TypeSafe, é um modelo feito para decidir. Você envia os dados e uma pergunta com as opções possíveis. Ele devolve a opção escolhida, a probabilidade de cada uma e uma confiança, sem texto livre.
confidence
probabilities
0,97
0,02
0,01
0,00
2. A mesma decisão com LLM e com Jev
Os dois lados usam o mesmo catálogo de intenções, com descrição e exemplos de cada uma. O que muda é a forma de perguntar.
Com o LLM, o código pede um JSON e interpreta o texto que voltou, com defesa para resposta vazia, inválida ou fora do catálogo.
// LLM: pede um JSON e interpreta o texto que voltou
var json = await llm.CompletarAsync(MontarPrompt(catalogo, conversa), MontarSchema());

if (!TentarLer(json, out var r) || !catalogo.Contem(r.Chave))
    return ResultadoIntencao.Seguro();   // vazio, inválido ou fora do catálogo

// confianca e precisaEsclarecimento foram escritos pelo próprio LLM
return new ResultadoIntencao(r.Chave, r.Confianca, r.PrecisaEsclarecimento);
Com o Jev, o código pede uma escolha entre as opções do catálogo.
// Jev: pede uma escolha entre as opções do mesmo catálogo
var resposta = await jev.PerguntarAsync(estado, new Choice(
    instrucao: "O que o cliente quer fazer na ultima_mensagem_do_cliente?",
    opcoes: catalogo.Select(i => new Opcao(i.Chave, i.Descricao, i.Exemplos, i.NaoE))));

// a confiança vem do modelo, a decisão vem do código
var precisaEsclarecimento = resposta.Confianca < limiar;
return new ResultadoIntencao(resposta.Escolha, resposta.Confianca, precisaEsclarecimento);
Trechos simplificados do agente.
3. Confiança escrita pelo modelo e confiança calibrada
No caminho do LLM, a confiança é um campo do JSON que o próprio LLM escreve. No caminho do Jev, ela vem do modelo e quem compara com o limiar é o código.
O LLM errou com quase a mesma certeza com que acertou: 0,93 contra 0,98. Um limiar sobre esse número deixaria passar quase todos os erros. No Jev, a confiança caiu para 0,71 nos erros, e o limiar separa os casos.
4. Três casos em que os dois discordaram
| Mensagem do cliente | LLM | Jev |
|---|---|---|
| “preciso anular aquela nota da Beta” | esclarecer, 0,86, errou |
cancelar_nfse, 0,99, acertou |
| “espera, antes me manda o pdf dela”, durante a confirmação de um cancelamento | ajustar, 0,96, errou |
esclarecer, 0,53, acertou |
| “manda ver” | confirmar, acertou |
fica em dúvida e pergunta de novo, errou |
No terceiro caso o Jev perde. Mas o tipo de erro importa: quando ele erra numa confirmação, o efeito é uma pergunta a mais para o cliente, sem executar nada.
5. Trocar sem risco: modo sombra e fallback
O fluxo do agente chama DecidirAsync(...) e não sabe quem responde. Um executor escolhe o modo pela variável AI__JEV__MODO.
Jev deu timeout ou erro? O executor chama o LLM e o agente segue.
O tempo perdido entra na métrica do dashboard.
Num dos dias de teste, chamadas do Jev passaram de 3 s.
6. A decisão dentro de um fluxo durável no skail
Quando a confiança fica abaixo do limiar, o agente pergunta de novo e espera a resposta do cliente, que pode levar minutos ou horas. No skail, essa espera é durável: a chamada ao Jev fica num passo atômico e a resposta do cliente chega por evento. O padrão completo está em Construindo agentes de IA com skail.
[SkailFunction]
public async SkailTask ConfirmarCancelamento(string conversaId, string notaId)
{
    var decisao = await DecidirConfirmacao(conversaId);   // chama o Jev

    if (decisao.Escolha == "confirmar" && decisao.Confianca >= 0.9)
    {
        await CancelarNota(notaId);                        // [SkailCommand]
        return;
    }

    await Responder(conversaId, $"Só para confirmar: cancelo a nota {notaId}?");

    var resposta = WaitForEvent<MensagemRecebida>("EVENTO_NOVA_MENSAGEM", conversaId);
    if (await WhenAny(resposta, DelayMinutes(15)) != resposta)
        await EncerrarConversa(conversaId);
}
Como o resultado do passo fica gravado, uma execução retomada depois de uma falha reutiliza a decisão já tomada, mesmo que uma nova chamada ao Jev devolvesse outra confiança.
7. Os números da rodada
| Métrica | LLM | Jev |
|---|---|---|
| Acerto | 95% | 96%, igual dentro da margem |
| Erros críticos | 0 | 0 |
| Tempo mediano | 1 s | 258 ms, 4× mais rápido |
| Custo a cada 1.000 decisões | US$ 0,92 | US$ 0,048, 95% mais barato |
O Jev usa uns 50% mais tokens, mas o token de entrada custa US$ 0,042 por milhão, contra US$ 0,75 do GPT-5.4 mini, e a saída é grátis.
Perguntas frequentes
O Jev substitui o LLM no agente?
Substitui as decisões. O narrador e a extração de dados continuam no LLM, porque o Jev não gera texto.
O que acontece se o Jev cair ou demorar?
O executor cai no LLM e registra o tempo perdido. O agente segue normalmente.
Preciso do skail para usar o Jev?
Não. O skail entra quando a decisão faz parte de um fluxo que precisa esperar o cliente, pedir revisão humana e sobreviver a reinícios.
Por onde começar no seu agente
- Escolha uma decisão com opções fechadas que hoje vai para o LLM. Confirmar uma ação irreversível é o melhor candidato.
- Monte casos rotulados à mão, incluindo respostas ambíguas como “manda ver”.
- Rode os dois caminhos em modo Sombra e compare acerto, tempo, custo e a confiança nos erros.
- Só depois deixe o Jev decidir, com fallback para o LLM.
Se você usa um assistente de IA para escrever esse código, entregue a ele as regras do skail antes.
- Construindo agentes de IA com skail: classificação de intenção, loop de conversa, espera por sistemas externos e human-in-the-loop, com o esqueleto completo em C#.
- Usar o skail com assistentes de IA: o arquivo de regras para Cursor, GitHub Copilot e Claude Code.