Na parte 1 a gente definiu execução durável como a capacidade de registrar o progresso de um processo e retomá-lo depois de uma falha ou de uma pausa. Lá ficaram os sete conceitos: registro de progresso, replay, retry, idempotência, determinismo, hibernação e paralelismo durável.
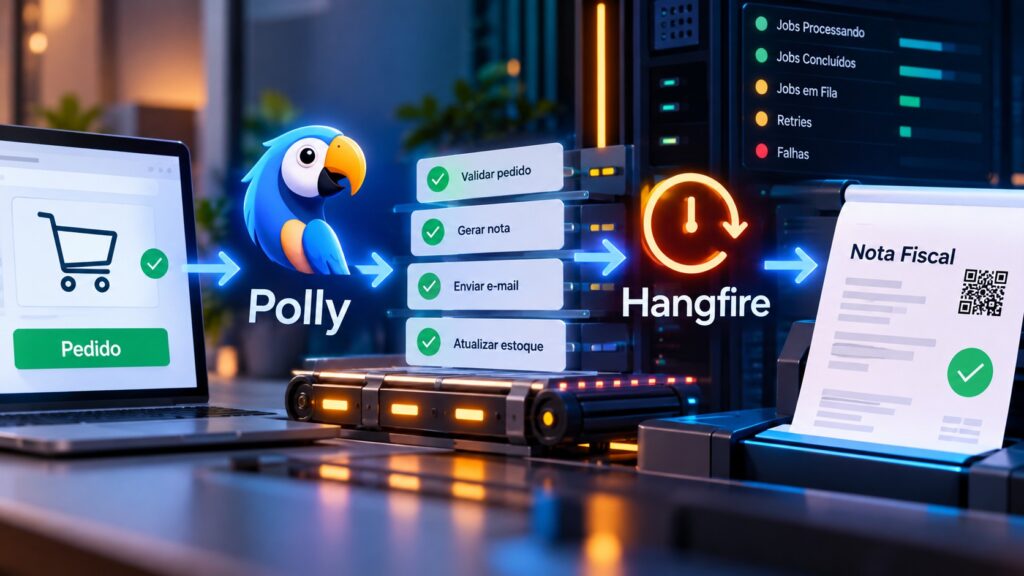
Este post é a parte prática. Vamos implementar um processo de negócio do começo ao fim e olhar, em cada passo, o que pode dar errado e como o sistema se recupera. O exemplo usa .NET, C#, Polly, Hangfire e Postgres, mas cada peça tem equivalente em outras linguagens, e elas aparecem ao longo do texto.
O processo: do pedido à nota fiscal
O usuário cria um pedido na tela. O backend autoriza o pagamento no gateway e espera a confirmação, que pode levar até 3 dias. Se a confirmação chega, o sistema captura o pagamento e emite a nota. Se o prazo vence antes, a autorização expira.
Cada passo desse fluxo fala com algo de fora: banco, gateway de pagamento, serviço de nota. Se o servidor reinicia entre a autorização e a captura, o processo precisa saber onde parou. Se a chamada ao gateway dá timeout, alguém tem que decidir se tenta de novo. E a espera de 3 dias não pode depender de um processo ficar vivo esse tempo todo.
As quatro peças da implementação
Para cobrir esses casos, a implementação tem quatro peças:
- Retry, para se recuperar de erros que passam sozinhos, como oscilação de rede ou banco indisponível por alguns segundos.
- Progresso salvo no banco, com o resultado de cada passo concluído gravado numa tabela.
- Worker que retoma de onde parou, lendo o que já foi feito antes de executar.
- Agendador, que guarda tarefas para daqui a horas, dias ou semanas e as dispara na data certa.
No exemplo, o Polly faz o retry, o Postgres guarda o progresso e o Hangfire faz o papel de worker e de agendador.
Retry: tentar de novo só quando o erro passa sozinho
Retry é repetir uma operação que falhou. A condição para isso funcionar é o erro ser transitório, ou seja, um erro que some sem ninguém mexer em nada. Um timeout na chamada ao gateway pode ser só uma sobrecarga daquele servidor naquele momento, e a tentativa seguinte passa. Um HTTP 400 por payload inválido vai falhar na primeira, na segunda e na décima tentativa, porque o problema está no dado.
Dar retry em erro que não é transitório só gasta tempo e carga do serviço do outro lado. Por isso a política de resiliência do exemplo começa com um método que classifica a exceção:
public static class PoliticaDeResiliencia
{
    // O que conta como transitório é decisão do seu time.
    public static bool EhTransitorio(Exception ex) => ex switch
    {
        TimeoutRejectedException => true,
        HttpRequestException { StatusCode: null } => true, // falha de conexão
        HttpRequestException { StatusCode: HttpStatusCode.ServiceUnavailable
                                        or HttpStatusCode.GatewayTimeout
                                        or HttpStatusCode.TooManyRequests } => true,
        NpgsqlException { IsTransient: true } => true,
        _ => false
    };

    public static ResiliencePipeline Criar() =>
        new ResiliencePipelineBuilder()
            .AddRetry(new RetryStrategyOptions
            {
                ShouldHandle = new PredicateBuilder().Handle(EhTransitorio),
                MaxRetryAttempts = 3,
                Delay = TimeSpan.FromMilliseconds(200),
                BackoffType = DelayBackoffType.Exponential // 200 ms, 400 ms, 800 ms
            })
            .Build();
}
Existe discussão sobre o que entra ou não como transitório. HTTP 429, por exemplo, depende de o serviço devolver um Retry-After que você respeite. O ponto é deixar essa classificação num lugar só, onde o time decide e ajusta.
O MaxRetryAttempts define quantas tentativas extras acontecem, três no exemplo. Pode ser fixo ou vir como parâmetro de quem executa o passo. O Delay é o tempo base, e o que o Polly faz com ele depende do BackoffType.
Quanto esperar entre uma tentativa e outra
Backoff é o intervalo entre as tentativas. O Polly tem três tipos, e a diferença fica clara com o mesmo tempo base de 200 ms:
- Constant espera sempre o mesmo tempo: 200 ms, 200 ms, 200 ms.
- Linear soma o tempo base a cada tentativa: 200 ms, 400 ms, 600 ms.
- Exponential dobra o tempo da espera anterior: 200 ms, 400 ms, 800 ms.
O exemplo usa o exponencial. Ele dá ao serviço do outro lado cada vez mais tempo para se recuperar, em vez de martelar no mesmo ritmo. Com muitas instâncias tentando ao mesmo tempo, vale ligar o UseJitter, que espalha as tentativas e evita que todas batam no serviço no mesmo milissegundo. O mesmo pipeline também pode receber um AddCircuitBreaker, que para de chamar o serviço por um período quando a taxa de falha passa de um limite.
O retry aplicado: o executor de passo
A política sozinha não faz nada. Ela é aplicada quando um passo do processo executa. No exemplo, isso fica num executor de passo genérico, que todo job usa:
var pipeline = PoliticaDeResiliencia.Criar();
var resultado = await pipeline.ExecuteAsync(
    async token => await acao(chave, token),
    ct);
O ExecuteAsync roda a ação dentro da política: se a ação lança uma exceção transitória, o Polly espera o backoff e tenta de novo, até três vezes. Como a política está centralizada no executor, todo passo do processo ganha o mesmo comportamento sem repetir código. Mais adiante o executor ganha a segunda função, que é o replay.
Quem usa HttpClient no .NET tem ainda o AddStandardResilienceHandler, do pacote Microsoft.Extensions.Http.Resilience, que monta um pipeline padrão com Polly por baixo. Nas outras linguagens:
- Node: cockatiel, p-retry
- Go: failsafe-go
- Java e Kotlin: Resilience4j, Spring Retry
- Python: Tenacity
Dá para fazer retry com fila também. Esse assunto fica para um post específico sobre filas.
Registro de cada passo: o código enfileira, o Hangfire executa
O processo começa no repositório de pedidos. O usuário criou o pedido na tela, a requisição passou pelo backend e chegou no método que grava o pedido. A parte web não importa aqui. O que importa é o que acontece depois do insert.
public async Task CriarAsync(Pedido pedido, CancellationToken ct)
{
    await using var tx = await _conn.BeginTransactionAsync(ct);

    var inserido = await InserirPedidoAsync(pedido, tx, ct);   // ON CONFLICT DO NOTHING
    if (!inserido) return;                                      // pedido já existia

    await RegistrarJobAsync(pedido.Id, "autorizar", tx, ct);   // INSERT pedido_job
    await tx.CommitAsync(ct);

    BackgroundJob.Enqueue(f => f.Autorizar(pedido.Id, CancellationToken.None));
}
O insert do pedido é código padrão, com transação e verificação de pedido duplicado. A execução durável começa nas duas linhas seguintes. Na mesma transação do pedido, o código grava um registro na tabela pedido_job dizendo que o próximo passo é autorizar. Depois do commit, enfileira no Hangfire o método Autorizar do fluxo de pagamento.
O registro em pedido_job é o que permite descobrir e reenfileirar um job que não chegou ao Hangfire, por exemplo se o processo cair entre o commit e o Enqueue.
Repare que o código não executa a autorização. Ele registra que ela precisa acontecer e entrega para o Hangfire, que decide quando executar e grava que executou.
O job que conhece o próximo passo
Quando o Hangfire executa o job, o Autorizar busca o pedido no banco e chama o executor de passo, o mesmo que já tem o retry embutido:
[DisplayName("Autorizar pedido {0}")]
public async Task Autorizar(Guid pedidoId, CancellationToken ct)
{
    var pedido = await _pedidos.ObterAsync(pedidoId, ct);

    var autorizacao = await _executor.ExecutarAsync(pedidoId, "autorizar",
        (chave, token) => _gateway.AutorizarAsync(pedido, chave, token), ct);

    await _pedidos.AtualizarStatusAsync(pedidoId, autorizacao.Status, ct);

    if (autorizacao.Status == StatusPedido.Autorizado)
        BackgroundJob.Schedule(
            f => f.Expirar(pedidoId, CancellationToken.None), TimeSpan.FromDays(3));
    else
        BackgroundJob.Enqueue(f => f.DecidirPagamento(pedidoId, CancellationToken.None));
}
Depois de autorizar, o job atualiza o status do pedido e, conforme a regra de negócio, enfileira o próximo. A execução fica encadeada: cada job sabe qual é o passo seguinte. O DisplayName é o nome que aparece no painel do Hangfire, onde dá para ver os jobs processados com sucesso (Autorizar pedido, Decidir pagamento, Emitir documento) e os agendados, como o Expirar confirmação marcado para daqui a 3 dias.
O Hangfire tem o próprio retry em nível de job: o AutomaticRetry reexecuta um job que falhou, 10 vezes por padrão. Isso é diferente do retry do Polly, e a diferença fica clara na seção sobre replay.
O que a infraestrutura precisa garantir
Esse desenho tem limites que o código não resolve. Se um job foi enfileirado para rodar hoje às 11h e o host do Hangfire está fora do ar, ele não roda às 11h. Roda quando o Hangfire voltar. O mesmo vale se o banco que guarda os jobs cair ou se a rede entre o Hangfire e esse banco falhar.
A execução durável depende do time de plataforma, de SRE ou, no mínimo, de um NOC monitorando essas peças. Se o servidor do Hangfire explodir e levar os jobs junto, o que salva é uma política de backup e restore testada, ou um ambiente de disaster recovery. Com os jobs restaurados, o Hangfire executa os pendentes quando voltar, conforme a política de execução, e nenhuma execução se perde. Esse custo operacional precisa entrar na conta antes de adotar o desenho, principalmente em time pequeno sem SRE dedicado.
Hibernação: o job que espera 3 dias
Hibernar, neste exemplo, é o Hangfire guardar um job agendado até a data em que ele precisa rodar. Quando o Autorizar dá certo, ele agenda o Expirar para daqui a 3 dias. Nesse intervalo, o que fica guardado é um registro no storage do Hangfire com a data de execução, sem thread ou processo parado esperando. Pode ser 3 dias, 5 dias ou duas semanas esperando uma confirmação.
[DisplayName("Expirar confirmação do pedido {0}")]
public async Task Expirar(Guid pedidoId, CancellationToken ct)
{
    // Só expira se o pedido ainda estiver parado em "autorizado".
    await _conn.ExecuteAsync(
        "UPDATE pedido SET status = 'autorizacao_expirada' WHERE id = @id AND status = 'autorizado'",
        new { id = pedidoId });
}
O WHERE status = 'autorizado' resolve a regra de negócio: se o pedido já foi confirmado, capturado ou entregue, o update não afeta nenhuma linha. O job, porém, continua agendado e roda na data dele mesmo assim.
Em volume, isso vira um ponto de atenção. Com 200 mil pedidos em 3 dias, são 200 mil jobs de expiração esperando, e a maioria vai encontrar um pedido que já avançou.
A alternativa é cancelar o job quando o pedido for confirmado. O BackgroundJob.Schedule devolve o id do job, que precisa ser guardado junto do pedido para depois chamar BackgroundJob.Delete. É mais uma operação, mais uma transação e mais código para manter. Nenhuma das duas opções é simples de desenvolver e manter, mas, com os cuidados certos, as duas resolvem.
Idempotência: autorizar duas vezes sem cobrar duas vezes
Com backup e restore, retry do Polly e retry do Hangfire, uma pergunta aparece: como garantir que a autorização não execute de novo quando o job for repetido? Ninguém quer autorizar o mesmo pagamento duas vezes porque o backup voltou.
É aqui que entra a idempotência. Uma operação é idempotente quando executar uma ou várias vezes produz o mesmo efeito de negócio. Para isso, cada chamada leva uma chave de idempotência, e quem recebe a chamada usa essa chave para reconhecer uma repetição.
No exemplo, a chave junta o id do pedido e o passo:
public static class ChaveIdempotencia
{
    public static string Criar(Guid pedidoId, string passo) => $"{pedidoId}:{passo}";
}
Como o id do pedido nunca se repete, toda chamada de autorizar para aquele pedido sai com a mesma chave, seja a primeira, um retry do Polly ou um replay depois de um restore. A chave vai no cabeçalho da requisição para o gateway:
using var req = new HttpRequestMessage(HttpMethod.Post, "/autorizacoes")
{
    Content = JsonContent.Create(new { pedido.Id, pedido.Valor })
};
req.Headers.Add("Idempotency-Key", chave);

var resposta = await _http.SendAsync(req, ct);
var resultado = await resposta.Content.ReadFromJsonAsync(ct);

_logger.LogInformation("Autorização do pedido {PedidoId}, duplicada: {JaExistia}",
pedido.Id, resultado!.JaExistia); Na primeira chamada, o gateway autoriza e guarda a chave. Na segunda, reconhece a chave e devolve a autorização que já existia. No exemplo o servidor de autorização é simulado. Numa integração real, o gateway seria Stripe, AbacatePay ou outro que você já usa, e cada um documenta como trata a chave.
A regra que monta a chave mora no seu código de negócio, numa classe separada. O gateway só cumpre a promessa se receber a mesma chave toda vez.
Retry e replay são coisas diferentes
O Polly faz retry, backoff e circuit breaker, e só para erros transitórios. Tem outro limite: o retry vive na memória do processo. Se o processo cai durante a segunda tentativa, o retry acaba ali. Não existe mais Polly, não existe mais contagem de tentativas.
Quando o Hangfire reexecuta esse job depois, o assunto passa a ser replay: rodar o job de novo do começo e reaproveitar o que já foi concluído. No exemplo, o replay mora no executor de passo, antes do Polly:
public async Task ExecutarAsync(Guid pedidoId, string passo,
    Func> acao, CancellationToken ct)
{
    // 1. Replay: se o recibo do passo existe, devolve o resultado salvo.
    var (achou, salvo) = await TentarLerResultadoAsync(pedidoId, passo, ct);
    if (achou) return salvo!;

    // 2. Executa com retry.
    var chave = ChaveIdempotencia.Criar(pedidoId, passo);
    var resultado = await _pipeline.ExecuteAsync(async t => await acao(chave, t), ct);

    // 3. Grava o recibo: INSERT INTO passo_concluido (pedido_id, passo, resultado_json)
    await GravarResultadoAsync(pedidoId, passo, resultado, ct);
    return resultado;
}
O TentarLerResultadoAsync consulta a tabela passo_concluido pelo pedido e pelo passo e devolve o JSON do resultado. Se o recibo existe, o passo não executa de novo. Se não existe, executa dentro do Polly e grava o recibo no final.
WHERE pedido + passo
Esse desenho também tem uma janela de risco. Se o processo cai depois de executar e antes do insert em passo_concluido, o recibo não existe e o passo roda de novo no replay. É exatamente nesse caso que a chave de idempotência evita a cobrança em dobro: o gateway recebe a mesma chave e devolve a autorização anterior. Replay e idempotência trabalham juntos, e nenhum dos dois sozinho fecha todos os casos.
Vale o custo?
Montar execução durável assim dá trabalho. Tem custo de mão de obra para desenvolver, custo operacional para manter Hangfire e banco no ar, e custo de infraestrutura. Cada peça que vimos pode falhar de um jeito diferente.
A conta é comparar esse custo com o custo do processo falhar: cobrar o cliente duas vezes, não cobrar, o Pix sair sem a nota, a nota sair sem o Pix. Cada processo precisa ser analisado com essa pergunta.
Também existe o caso em que execução durável não se aplica. Se o processo cabe numa transação, é síncrono com a tela e o usuário precisa do retorno na hora, sem possibilidade de virar assíncrono, ele fica como está. Execução durável exige execução assíncrona.
Banco e agendador em outras linguagens
O Postgres guardou o progresso no exemplo, mas a tabela de recibos funciona em MySQL, SQL Server, Oracle, MongoDB, Redis, DynamoDB ou num event store como o KurrentDB (antigo EventStoreDB). O requisito é gravar o resultado de cada passo de forma durável e conseguir ler pelo pedido e pelo passo.
No lugar do Hangfire, o que importa é o agendador persistir os jobs fora da memória do processo:
- .NET: Quartz.NET com job store em banco, TickerQ
- Node: Agenda, BullMQ com jobs atrasados
- Ruby: Sidekiq com
perform_in, que agenda o job no Redis - Go: River
- Java e Kotlin: Quartz com JDBC job store, JobRunr
- Python: Celery com
countdownoueta, APScheduler com job store em banco
Agendadores que guardam o cronograma só em memória, como o node-cron ou um @Scheduled do Spring, perdem o agendamento quando o processo reinicia e não servem para esperar 3 dias.
O mesmo processo com o skail
Este post sai no blog da skail, e o skail é a plataforma de execução durável que a gente constrói aqui. Fica o vínculo declarado antes de mostrar como o mesmo processo ficaria com ele.
[SkailFunction] Processar
  await Autorizar // [SkailCommand]
  WaitForEvent(confirmação)
  Delay(3 dias)
  WhenAny → prazo? Estornar
  await Capturar // [SkailCommand]
  await EmitirNota // [SkailFunction]
  await Concluir
[SkailFunction]
public async SkailTask Processar(Guid pedidoId)
{
    var autorizacao = await Autorizar(pedidoId);

    var confirmacao = SkailTask.WaitForEvent(Eventos.ConfirmacaoPagamento, pedidoId.ToString());
    var prazo       = SkailTask.Delay(TimeSpan.FromDays(3));

    if (await SkailTask.WhenAny(confirmacao, prazo) == prazo)
    {
        await Estornar(pedidoId, autorizacao.Id);
        return;
    }

    await Capturar(pedidoId, autorizacao.Id);
    await EmitirNota(pedidoId);   // outra [SkailFunction], com histórico próprio
    await Concluir(pedidoId);
}

[SkailCommand]
public async SkailTask Autorizar(Guid pedidoId)
    => await _gateway.AutorizarAsync(pedidoId, ChaveIdempotencia.Criar(pedidoId, "autorizar"));
O Processar autoriza o pagamento e cria duas esperas: o evento externo de confirmação e o prazo de 3 dias. O WhenAny devolve a que terminar primeiro. Se o prazo vence, o fluxo estorna. Se a confirmação chega antes, captura, emite a nota e conclui.
O Autorizar e o Capturar são [SkailCommand], os métodos que fazem as operações de I/O do fluxo. A chamada ao gateway continua normal, igual ao código sem skail. A diferença é que o retry, a retomada de onde parou e o replay vêm junto, e o Delay hiberna a execução sem ocupar thread nem processo. Saem do código o Polly, o Hangfire, a tabela de recibos, o job de expiração por pedido e o encadeamento manual.
O código continua rodando na sua infraestrutura, no mesmo host onde a aplicação já roda hoje. Observabilidade e depuração com time travel ficam para outro post. Se quiser ver as primitivas usadas aqui, a referência do WaitForEvent tem um exemplo de espera com prazo, e o quickstart em C# mostra como começar. O trecho acima é um exemplo para comparar os dois desenhos.
Recapitulando
| Conceito | Onde ficou no exemplo | Limite |
|---|---|---|
| Retry | Polly no executor de passo, só para erro transitório | Morre junto com o processo |
| Registro de cada passo | Tabela pedido_job e jobs encadeados no Hangfire | Depende do Hangfire e do banco no ar |
| Replay | Tabela passo_concluido lida antes de executar | Janela entre executar e gravar o recibo |
| Idempotência | Chave pedidoId:passo no cabeçalho para o gateway | O serviço de destino precisa respeitar a chave |
| Hibernação | BackgroundJob.Schedule de 3 dias | Um job por pedido, mesmo quando não há nada a fazer |
Perguntas frequentes
O retry do Polly não resolve sozinho? Resolve erro transitório dentro de um processo vivo. Se o processo cai, as tentativas pendentes somem. Para continuar depois de um restart, você precisa de replay, com o progresso salvo fora da memória.
Preciso do retry do Polly se o Hangfire já reexecuta jobs? São camadas diferentes. O Polly repete uma chamada em milissegundos, dentro do mesmo passo. O AutomaticRetry do Hangfire reexecuta o job inteiro, com intervalos maiores. Com replay no executor de passo, a reexecução do job pula o que já foi concluído.
Por que a chave de idempotência usa o passo além do id do pedido? Porque o mesmo pedido passa por autorização e captura no mesmo gateway. Com só o id do pedido, a captura chegaria com a chave da autorização e seria tratada como repetição.
Por onde começar na sua aplicação
Pegue um processo que hoje roda em background e fala com pelo menos um serviço externo. Marque quais passos alteram dados fora do seu banco, quais erros desses passos são transitórios e qual chave identifica cada chamada sem ambiguidade. Com essas três respostas, dá para decidir se o processo precisa de execução durável e quanto do desenho deste post ele precisa.